中国算力,真比美国少了七倍吗?
有钱,不一定买得到算力。
今年流出的一段投资人交流录音里,DeepSeek 创始人梁文锋说了一句很有意思的话:如果今年能把约 200 亿元花在算力上,采购部门就算干得"超级好"了。
这听起来像个财务玩笑:有钱,为什么还怕花不出去?
因为先进 GPU 不是想买多少就能买多少。梁文锋的说法是,价格合理就尽量买,愿意多付一点,也要把能用的钱都换成卡。
做了十年手机,我对这种焦虑很熟悉。每年旗舰发布前,最难的不是设计,是备货:芯片、屏幕、内存,供应链给你多少,你就只能卖多少。钱在手里,货在别人手里。
大模型的竞争,正在变成一样的事。
几个月后,研究机构 Epoch AI 公布了一组数字,正好能解释这种焦虑:2022 年到 2026 年 6 月,流向美国的新增先进 AI 算力,约是中国的 7.5 倍。
那么,中国的 AI 实力真差了七倍吗?还是说,中国的算力被严重低估了?
答案要从这个数字到底算了什么说起。
一、7.5 倍:买进来的,不是全部家底
Epoch AI 综合了芯片销量、各国海关数据、服务器配置和转口路径,估算出这段时间全球约有 2700 万 H100 等效算力(H100e)到货。其中美国约 1980 万,占 72%;中国约 260 万,约占一成。
H100e 不是数卡的张数,而是把不同芯片折算成同一把尺子。
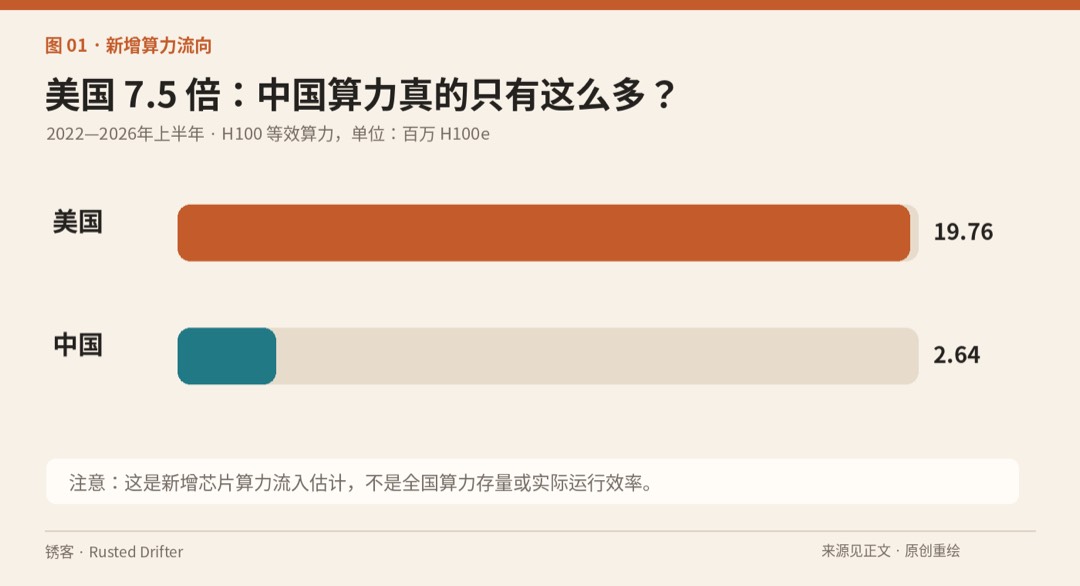
这里有个细节,比倍数本身更有意思:按这套估算,中国拿到的 AI 芯片数量占全球 18%,折算成算力却只有一成左右。
卡的数量和卡的能力,从一开始就不是一回事。
还有两点容易被忽略。
第一,国产芯片已经算进去了。 Epoch AI 把华为、寒武纪的产品都纳入了估算。难算的是型号分布、经第三地转运的设备,以及没公开的交付。所以换一套假设,中国的估算会在 190 万到 420 万 H100e 之间浮动。260 万是一个模型估计,不是一份能逐台点名的清单。Epoch AI 自己也说,这是"建模估算,不是已安装芯片的清点"。
第二,国内公布的算力规模,不能拿来直接反驳。 工信部今年 7 月披露,截至 6 月底,我国智能算力规模达到 2185 EFLOPS。这是按特定精度算的设施总能力;Epoch AI 算的是四年多新增芯片的 H100 等效值。两个数字都值得看,但用的不是同一把尺子,不能相减,也不能互相否定。
所以,7.5 倍不等于中国 AI 只有美国的七分之一。但它也不是可以忽略的噪声:今天买进来的卡,就是未来几年的家底。
二、GPU 会过时,但不会一夜报废
数据中心不是网吧。新一代显卡发布,旧卡不会当天就被拔掉电源。它可能不再适合最贵的前沿训练,但还能跑推理、跑企业模型、跑科研计算。
真正变的是账:同样一件活,新卡更快、更省电,旧卡就从"能用"变成了"不划算"。
美国云厂商的财报,恰好把这种不确定性摆在了桌面上。2025 年,亚马逊把一部分服务器和网络设备的折旧年限从 6 年缩短到 5 年,理由是 AI 技术迭代太快,当年折旧费用因此多了约 14 亿美元。同一年,Meta 却把大部分服务器的折旧年限延长到了 5 年半。
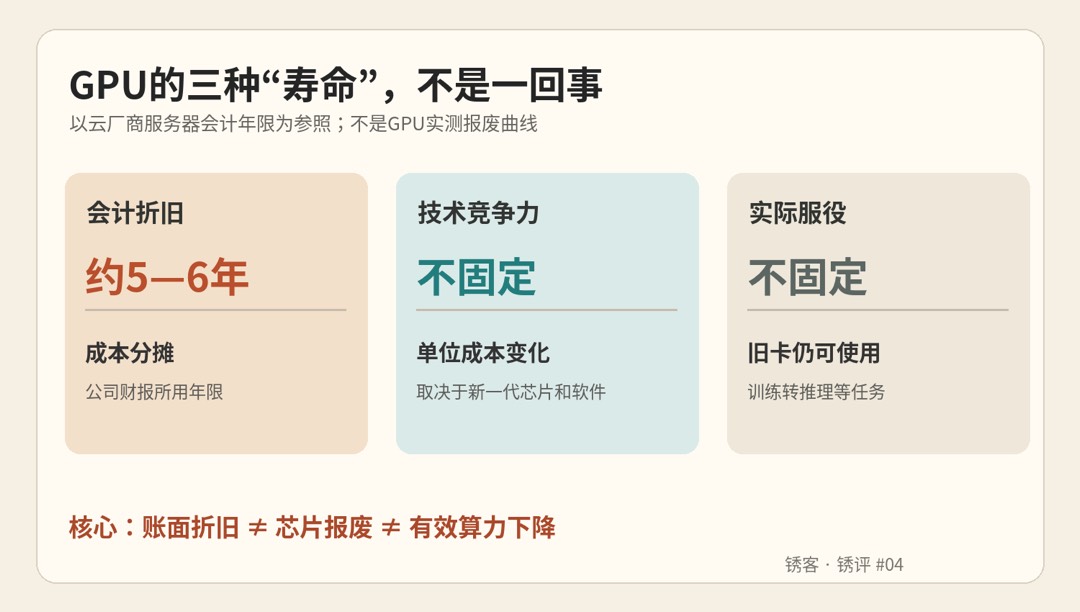
一个缩短,一个延长,说明行业根本没有统一的 GPU 淘汰时钟。
做手机的人对这个不陌生:一款芯片从旗舰退下来,还会在中端机上再卖两年。退出前线,不等于退出市场。
所以新增算力的差距,会沉淀成未来几年的供给条件,但不能机械地换算成"落后几年"。要算清某一天真正能用的算力,还得知道历年装了多少、每代性能如何、退役了多少、利用率多高。这张完整的存量表,目前没有人能给出来。
还有一个更难的问题:就算卡还在转,谁有权用它?
三、芯片有地址,算力有主人
Synergy Research 今年 8 月的统计:全球前 20 个超大规模数据中心市场里,15 个在美国;亚马逊、微软、谷歌三家合计占全球超大规模数据中心容量的 57%。北京和上海也在前 20 名里,广东今年新进榜。
与此同时,算力正在跨国铺开。OpenAI 和合作伙伴宣布在阿联酋规划 1GW 的 Stargate 集群;阿里云也在扩展欧洲、中东和东南亚的云区域。
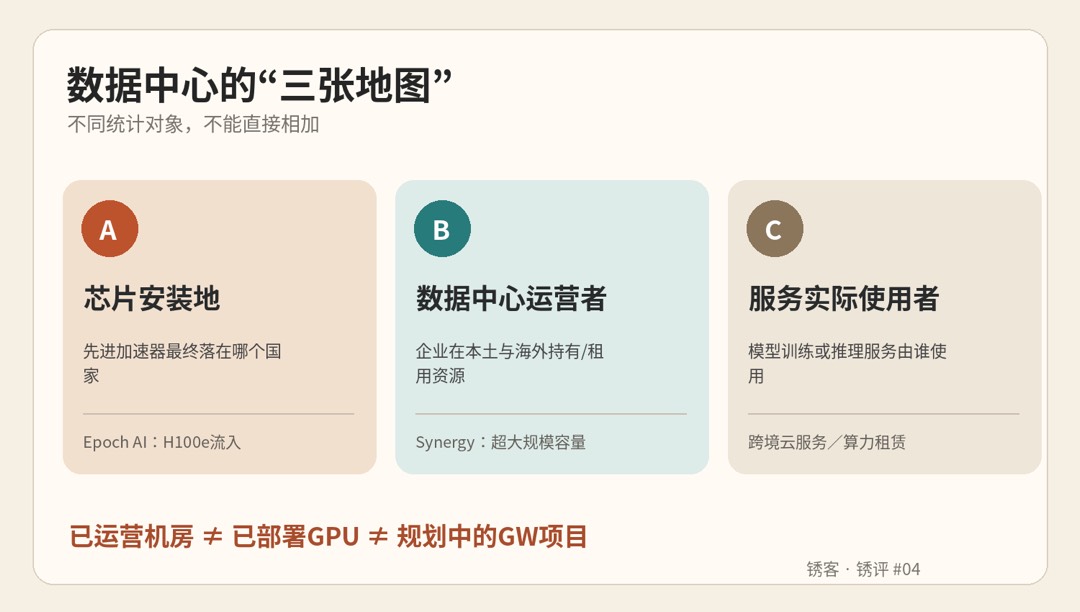
这些数字不能互相换算:规划中的园区不是已交付的 GPU,一个云区域也不是一座万卡集群。更重要的是,机房在哪、归谁所有、谁能租到,是三件事。出口许可、跨境数据规则、网络延迟和价格,决定了一家公司实际够得着多少算力。
于是问题落到了更难的一步:如果下一代训练需要成批换卡,自己的供应链能交付多少?
四、国产芯片:发布会和货架之间,隔着量产
华为今年 9 月在全联接大会上更新了昇腾路线图:昇腾 960 提前到 2027 年一季度,性能大约翻倍;之后按"一年一代"的节奏推进。华为也不再只谈单颗芯片,而是把超节点、互连、存储和集群放在一起讲,说已经部署了 1000 多个昇腾超节点。
但做过手机的人都知道,发布会上的芯片和货架上的手机之间,隔着两道不上镜的关:良率和产能。
AI 集群更复杂。它需要的不只是计算核心,HBM 高带宽内存、先进封装、互连网络、编译器和算子,都要同时就位。少一环,纸面上的峰值再漂亮,也变不成稳定的训练吞吐。
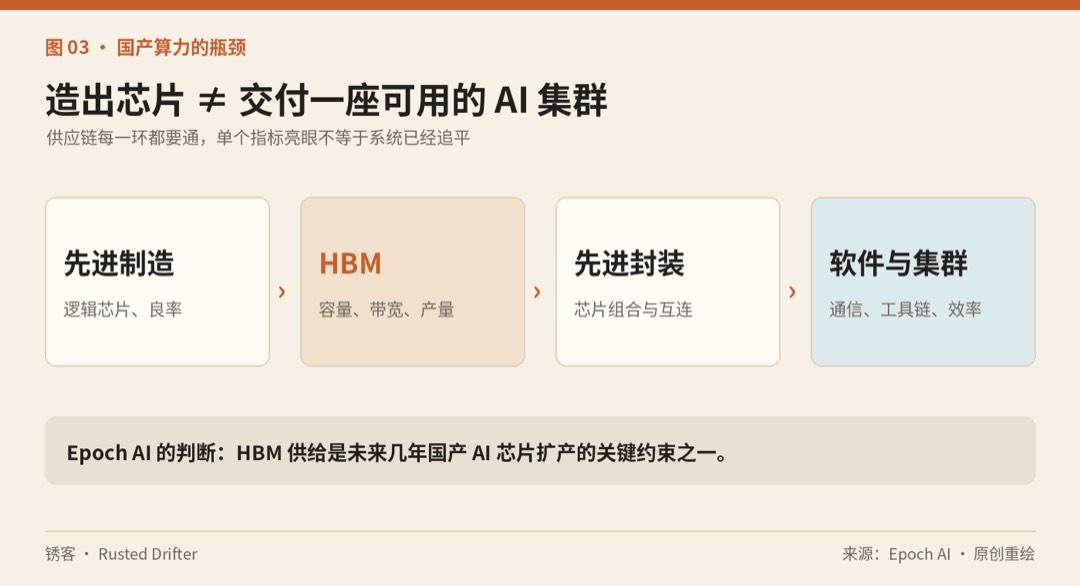
Epoch AI 对华为的研究把 HBM 列为近期最主要的供应约束。不过要说清楚:它对产量和性能的预测是研究模型,不是已经交付的验收数据。华为的路线图是厂商的时间表,两者要分开看。
软件也在变。梁文锋对 TileLang 这类降低 CUDA 依赖的编程工具抱有信心,但同时反复提到国产芯片供给不足。这里的区别很要紧:
编译器能让一块芯片跑得更高效,但编译不出另一块芯片。能跑、能高效地跑、能连续几个月稳定地跑,是三道不同的门槛。
五、没写进账单的,才是下一轮竞争
说到这里,有一个看起来矛盾的现象:中国模型已经很有竞争力了。
DeepSeek-V3 用 MoE、MLA 和训练系统的协同优化,把有限的 GPU 榨得很干;斯坦福今年的 AI Index 也显示,中美头部模型在不少评测上的差距已经明显缩小。
模型能力都接近了,是不是说明多买卡已经不重要了?
DeepSeek 自己的技术报告,给了一个反直觉的答案。报告披露,V3 的正式训练用了 278.8 万个 H800 GPU 小时,同时专门注明:这个数字不包括此前在架构、算法和数据上的研究和消融实验。
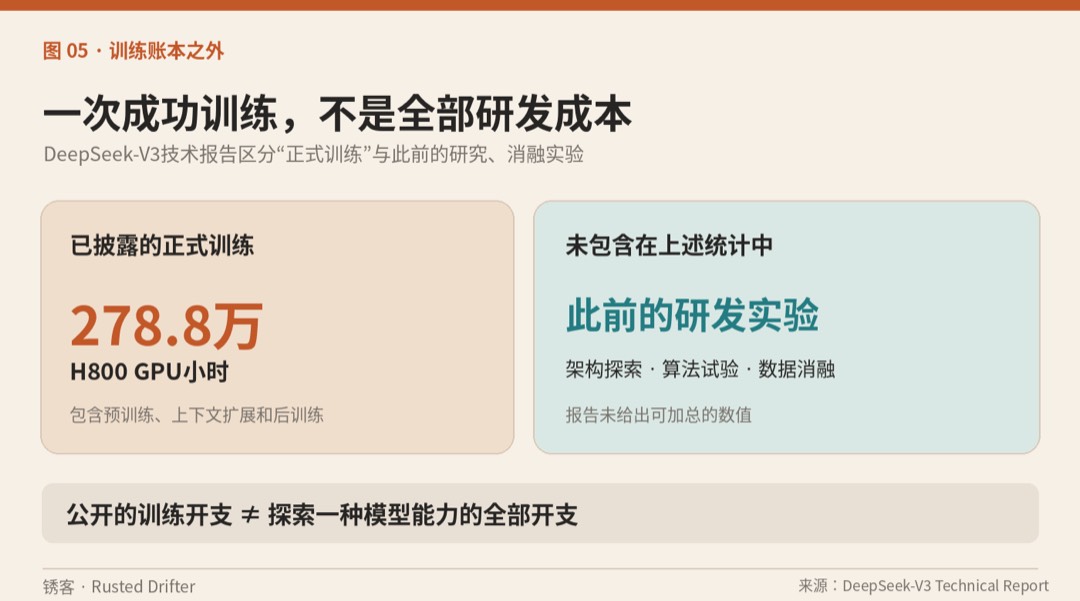
那些没成功的尝试,也在烧算力。有些想法,可能因为预算不够,根本没机会开始。
这正是梁文锋话里的另一层意思:算力不够,限制的不只是模型能训多大,更是团队能试错多少次。
效率能让一次训练更省钱;稳定的供给,决定下一次实验还能不能开始。
写在最后
7.5 倍不是中国 AI 竞争力的最终分数。它没算存量,没算旧卡的余热,没算跨境租用,更量化不了模型有多聪明。
但它指出的供给差距是真的。先进算力不是买一次就永远拥有的东西,它要不停地更新、供电、互连、调试,再投入使用。
中国模型的进步说明,工程效率可以显著放大有限硬件的产出。但长期的竞争,还取决于下一轮芯片能不能按时交付。
我们习惯给一个成功的模型算训练成本,却很少问:为了这一次成功,它失败过多少次?又有多少实验,因为缺算力,连失败的机会都没有?
排行榜记录的是成功的那一次。算力决定的,是失败之后,还能不能重来。
锈了,还在路上。
参考资料(核对日期 2026-11-02)
- 梁文锋投资人交流录音相关报道:每日经济新闻、证券之星等(2026-07)
- Epoch AI:AI Chip Imports 数据集及方法说明(2026-10);Huawei's Roadmap to 2031
- 工业和信息化部:国新办 2026 年上半年工业和信息化发展情况发布会(2026-07-20)
- 亚马逊、Meta 2025 年度报告(10-K)中关于服务器折旧年限的调整
- Synergy Research:全球超大规模数据中心市场排名(2026-08)
- OpenAI:Stargate UAE 发布;阿里巴巴集团云基础设施披露(2026-09)
- 华为全联接大会 2026 主题演讲及相关报道(2026-09)
- DeepSeek-V3 Technical Report(2024-12);斯坦福 HAI:2026 AI Index Report