回炉 03|Agent 学会“做梦”了:大模型的记忆是怎么搭起来的
AI 的记忆不是一个功能开关,而是一整套系统:谁来写、写成什么样、什么时候拿出来、什么时候忘掉。
引子:两个实验
第一个实验是 Anthropic 做的。
11 月 6 日,Anthropic 发了一篇研究文章,讲 Agent 的记忆。其中一个实验,是让几代 Claude 玩《宝可梦:红》,每个模型都有一个可以自己读写的记忆文件夹。
跑到大约 1 万步时,Sonnet 3.7 写了 413 个记忆文件、分在 225 个文件夹里,只拿到 1 枚徽章;它甚至有一段 17 步的时间新建 6 个文件、删掉 9 个,游戏里一步没走。Fable 5 只维护了 9 个文件,外加一个顶层的 global.md,拿到 4 枚。Opus 5.5 用一套精简、不断改写的记忆,最后通关。
还有一个细节:Claude 有一条笔记把山洞口一个地标的方位记反了,照着它走,连续三次掉回原路,第三次之后干脆放弃了。研究人员让 Claude 在空闲时“睡一觉”,对照原始记录核对笔记,发现错误、改正。用改对的笔记重跑,它直接回到洞里,走到了下一座城市。
Anthropic 把这个整理过程叫作“做梦”(Dreaming)。
这篇原文信息密度很高,我逐段做了一份中文精读译注,文末告诉你怎么领。
第二个实验是我自己做的。
前几天看到一篇文章,介绍了一段“审计提示词”:让 ChatGPT 列出它能看到的、关于你的所有信息,标明来源和可信度,区分“已保存的记忆”和“这次临时推出来的判断”。
我用了 GPT 很长时间,就拿自己试了一下。结果,它把我整理成了 10 个维度、59 条记忆点:身份与生活背景、职业与专业能力、AI 与技术兴趣、学习方式、人文兴趣、家庭教育、生活方式、沟通偏好、认知与心理推断、隐私与治理。
里面有我主动告诉它的,比如习惯用中文、喜欢先看框架再看细节;有它从对话里总结出来的,比如我在研究哪些技术方向;还有一些涉及家人、行政事务的敏感内容(我已经去敏)。最让我意外的,是其中有 8 条“认知与心理推断”:它判断我“倾向建立结构与因果模型”“可能偏好覆盖更多边界和反例”,甚至“可能存在准备过多、执行反馈不足的风险”。
这些都不是我说过的话,是它“读”出来的。
这并不是个例。今年 2 月有一项研究,分析了 80 位真实用户的 2050 条 ChatGPT 记忆:96% 是系统自己决定写进去的,不是用户要求的;28% 包含欧盟 GDPR 定义的个人数据;52% 包含对用户的心理洞察。好在 84% 能在用户的对话里找到直接依据,大多数不是瞎编。
两个实验放在一起,引出了这篇想讲清楚的问题:AI 的记忆,到底是怎么搭起来的?
一、先把地基讲清楚:大模型本身没有记性
大模型的每一次回答,都是从零开始的。你昨天跟它聊了一下午,今天打开新对话,模型本身对昨天一无所知。它能“想起来”,是因为产品在后台把相关内容找出来,放进了这次对话的输入里。
所以,“AI 的记忆”说到底是一个工程问题:在合适的时候,把合适的东西放回模型眼前。 这件事有四种底层办法。
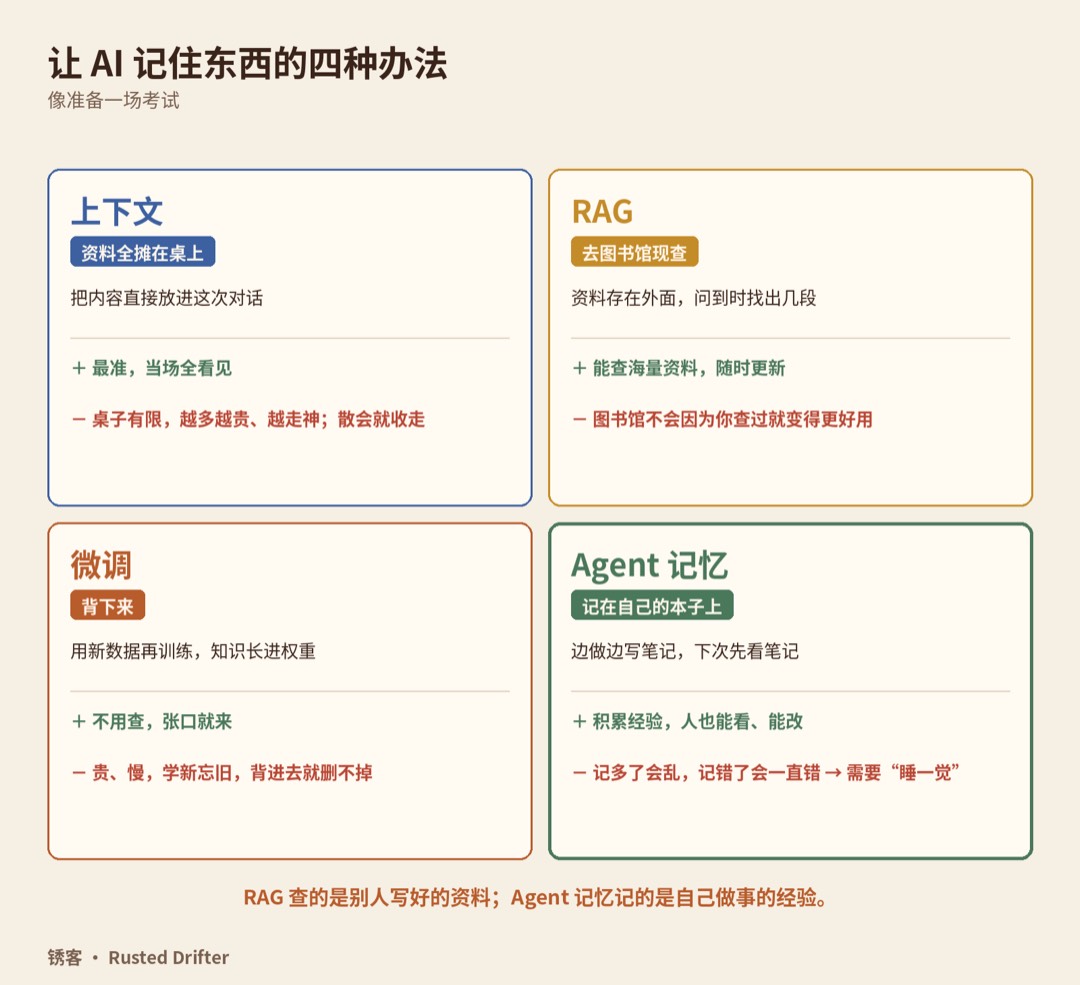
打个比方,你要准备一场考试:
- 上下文,是把资料全摊在桌上。模型这一次能看见的所有内容都在这里,最准,但桌子有限,越多越贵、越容易走神,考完就收走。
- RAG(检索增强),是去图书馆现查。资料放在外面的数据库里,问到时按相关性找出几段。它能查海量资料,但图书馆不会因为你查过一次就变得更好用。
- 微调,是把知识背下来,写进模型的权重。不用查,张口就来;但贵、慢,学新的会忘旧的,而且背进去就删不掉。所以没有哪家会把“你喜欢喝美式”写进模型权重。
- Agent 记忆,是记在自己的笔记本上。Agent 边做事边写笔记,下次先看笔记。和 RAG 最大的区别是:RAG 查的是别人写好的资料,Agent 记忆记的是自己做事的经验。
Anthropic 给 Agent 记忆下的定义很清楚:跨会话保留、以可读文字保存的经验。它明确排除了三样东西:改模型权重、单次对话里的临时学习、以及对话太长时的压缩摘要。
今天各家产品的“记忆功能”,基本都建在上下文和 RAG 之上,往 Agent 记忆的方向走。具体怎么搭,差别很大。下面拆开两家来看。
二、拆开 ChatGPT:四层上下文,每次全塞
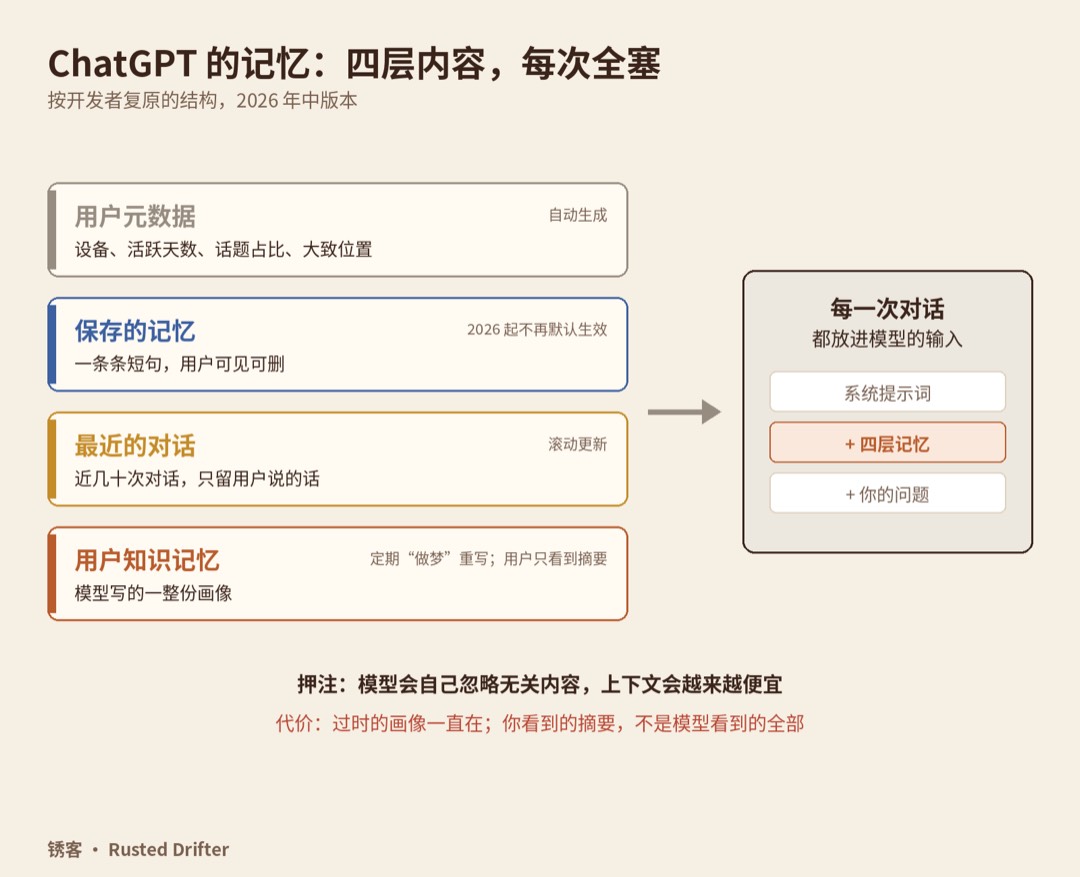
OpenAI 没有完整公开过记忆的架构。但有开发者让 ChatGPT 复述系统输入,对照多次测试,把它的结构拼了出来。按 2026 年中的版本,大致有四层:
第一层:用户元数据。 由使用行为自动生成,比如设备类型、账号注册多久、最近 1 天、7 天、30 天活跃了几天、平均对话深度、平均消息长度、常用哪些模型、订阅档位、按 IP 估计的大致位置,甚至还有一个话题占比,比如“编程相关 28%”。
第二层:保存的记忆。 这是最早的那种记忆:一条一条的短句,带时间戳,比如“用户对贝类过敏”。用户在设置页能看到、能删。2026 年的更新之后,这一层不再默认生效。
第三层:最近的对话。 早期测试里是最近约 40 次对话,每次带时间和主题,只保留用户自己说的话,不保留 AI 的回答。
第四层:用户知识记忆。 这是最关键也最不透明的一层:模型定期读你的聊天记录,写出一份很密的个人画像,比如你在做什么项目、用什么工具、旅行计划和预算、健身习惯。早期用户看不到这一层;今年 6 月起,OpenAI 把这个定期整理的过程也叫“做梦”,并在设置里加了一个“记忆摘要”页面。
关键在于怎么用:这四层内容,在每一次对话时都和系统提示词一起放进模型的输入。不管你问的是 Python 报错还是周末去哪玩,模型都能看到全部画像。
有人把这叫作 OpenAI 的“苦涩的教训”式押注:不做精巧的检索、不建向量库和知识图谱,把所有东西都给模型,相信两件事,一是模型够聪明,能自己忽略不相关的内容;二是上下文会越来越长、越来越便宜。
这套做法的好处是简单、个性化强,你会觉得它“很懂你”。代价也很明显:
- 过时的信息会一直在。 有人测试发现,一次计划了但没成行的旅行、一个早就放弃的项目,都留在画像里。OpenAI 自己公布的评测里,新系统在“时效类”问题上的准确率是 75.1%,也就是大约四分之一的时候,它记着的还是过时的你。
- 你看到的不是模型看到的。 有开发者指出,“记忆摘要”页只是给用户看的一个视图,每次生成的内容还不完全一样;用户在页面上的修改,存成了一段对话记录,而不是直接改掉底层的画像。
- 大部分是它自己决定记的。 前面那项研究里的 96%,说的就是这件事。
回头看我的审计结果,GPT 给每条记忆标的来源也印证了这套结构:有的来自“历史摘要”,有的来自“检索出的旧对话”,有的来自关联的邮件和文件,还有那 8 条,是这次审计时“新生成的推断”。它自己也说明了:能检索到的历史内容,不等于已保存的独立记忆条目。 用户其实很难知道,哪些东西在下一次对话里真的会被拿出来用。
三、拆开 Claude:按主题记,用的时候再查
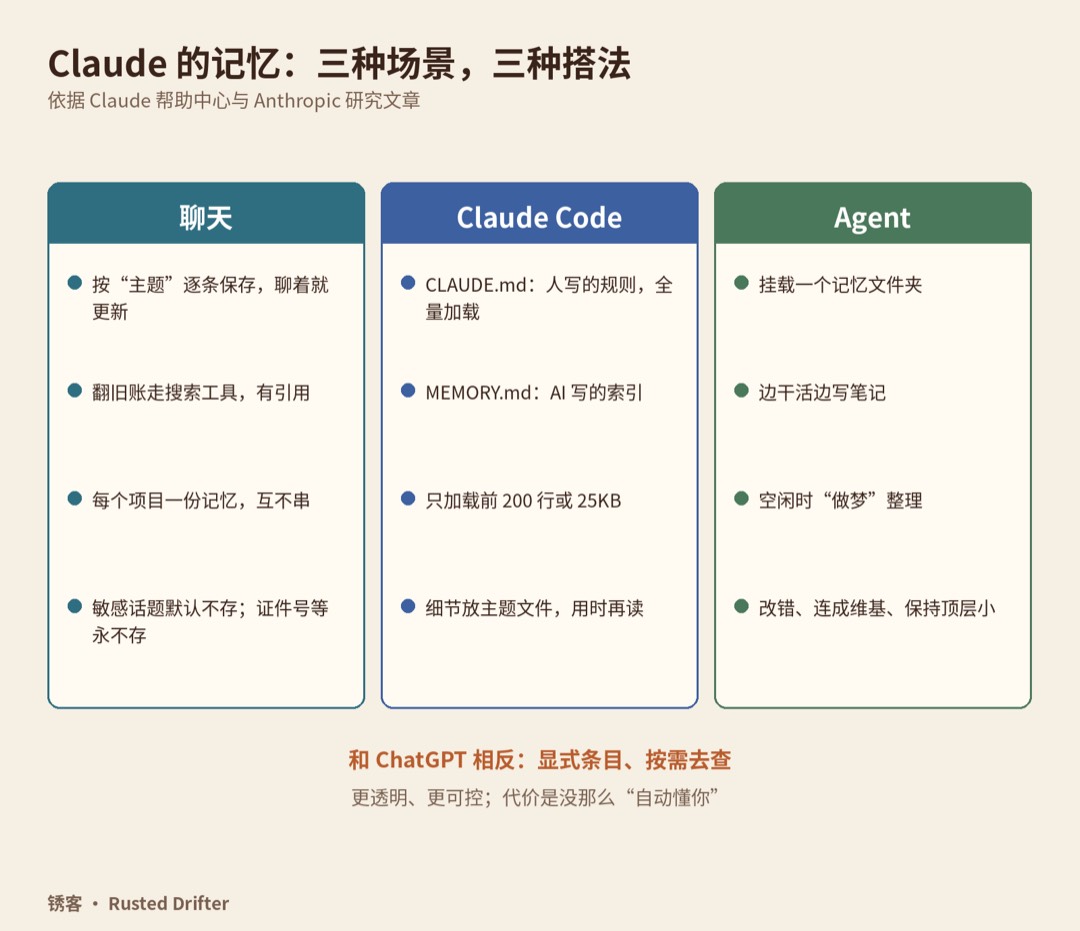
Claude 的做法几乎是反过来的,而且官方文档写得比较清楚。按使用场景,可以分成三种。
1. 聊天里的记忆:主题条目 + 按需搜索。
Claude 的记忆最近改过一次版。旧版是每 24 小时把你的聊天记录合成一份摘要,每个项目各自一份。新版改成:在聊天过程中,按“主题”一条一条地保存,比如“截止日期改到了下周”,下一次对话就已经知道,不用等每天的汇总。
官方说明里列了它主要记什么:你的角色和工作背景、工作和生活里的人和地方、沟通偏好和工作风格、技术偏好和代码风格、项目细节和进展。
跟 ChatGPT 最大的区别有三个:
- 翻旧账要走“工具调用”。 想找以前聊过的内容,Claude 会调用一个搜索过往聊天的工具(官方明确说是 RAG),对话里能看到这次调用,回答里有指回原对话的引用。用了什么、从哪来,用户看得见。
- 按项目隔离。 每个项目有自己的记忆;在项目里,Claude 只会用到这个项目和项目外的通用记忆,不会串到别的项目。写代码的记忆,不会跑到写公众号的对话里。
- 敏感信息分级。 健康、种族、宗教、政治、性别认同这类话题,默认不存,用户主动开启后才存,而且每存一条都会提示;还有几类信息无论如何都不存:证件号码、犯罪记录、金融账户号码和移民身份。
2. Claude Code 里的记忆:两份 Markdown 文件。
写代码的场景更直接,记忆就是磁盘上的文件:
- CLAUDE.md:人写给 AI 的规则,比如项目怎么构建、代码风格是什么,每次会话全量加载。分个人、项目、组织几个层级。
- 自动记忆:Claude 自己写,存在一个记忆文件夹里。MEMORY.md 当索引,具体内容放在一个个主题文件里。按 Anthropic 研究文章里的说法,每次只加载 MEMORY.md 的前 200 行或 25KB,其余的需要时再去读。
3. Agent 的记忆:记忆文件夹 + 做梦。
在 Anthropic 给开发者的托管 Agent 服务里,记忆是一个挂载的文件夹,Agent 边做事边往里写,空闲时再“做梦”整理。这正是开头宝可梦实验的设置。
两家对比下来,路线很清楚:ChatGPT 是“隐式画像、每次全塞”,Claude 是“显式条目、按需去查”。 前者更省心、更“懂你”,后者更透明、更可控。
再加上 Google:Gemini 一边有用户主动保存的“已保存信息”,一边通过“个人智能”接入 Gmail、相册、YouTube 观看记录和搜索记录,用到时再从这些账号数据里取。它的记忆,很大一部分不是从聊天里来的,而是从你的整个 Google 账号里来的。 这也是 Google 和手机厂商做记忆的天然优势。
四、记忆的“形状”:从便签、画像、文件夹到本体
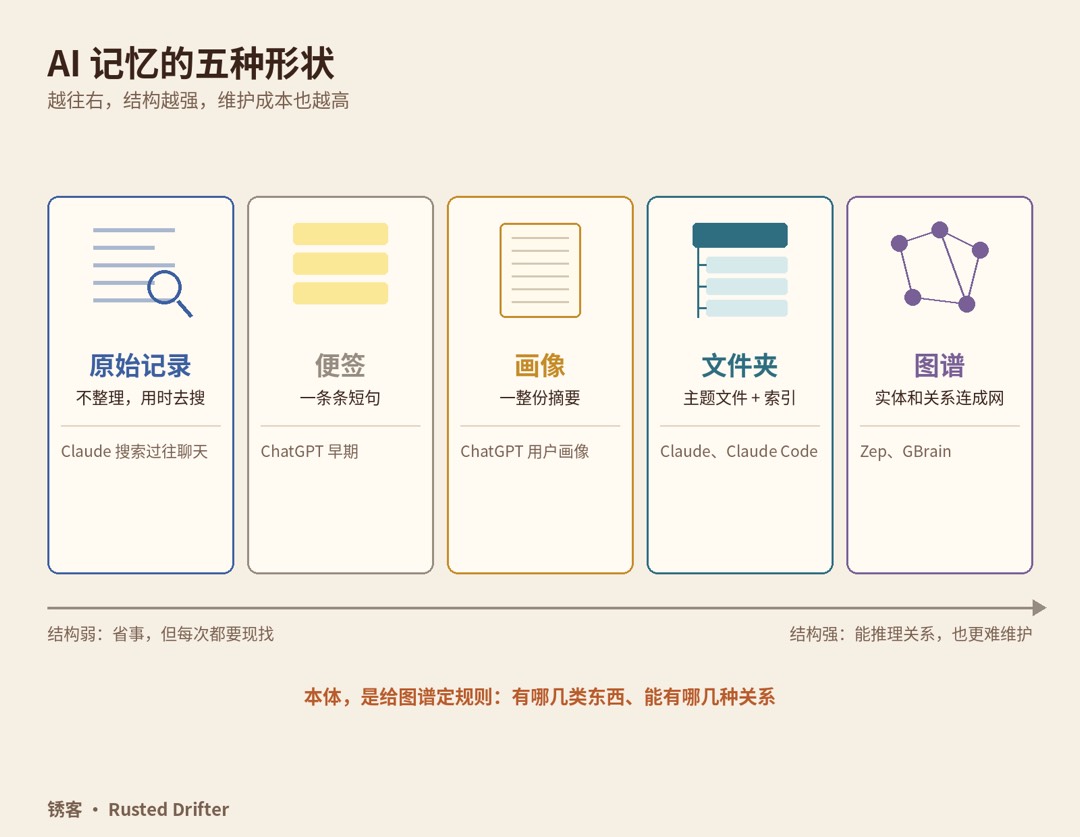
如果把各家做法放在一起看,记忆最终会被存成几种不同的“形状”,按结构从弱到强排:
1. 原始记录:干脆不整理,用的时候去搜。 Claude 的“搜索过往聊天”就是这一类。Anthropic 在研究文章里也说,把搜索原始记录作为记忆的地基,是一个合理的选项。
2. 便签:一条一条的短句。 ChatGPT 早期的“保存的记忆”就是这样。简单、好删,但条与条之间没有关系,也没有时间概念。
3. 画像:一整份摘要。 ChatGPT 的用户知识记忆、Claude 旧版的每日摘要都属于这类。信息密度高,读起来像一份人物小传;问题是整份重写,改一处容易牵动全身,过时信息也藏在里面不容易被发现。
4. 文件夹:按主题分开的文档,加一个索引。 Claude 新版的主题条目、Claude Code 的 MEMORY.md、Anthropic 研究里的记忆文件夹都是这个思路。人和 AI 都能读、能改,可以分层加载。宝可梦实验里 Fable 5 那个 global.md,就是一个当“仪表盘”用的顶层索引。
5. 图谱:实体和关系连成的网。 开源方案 Zep 用的是“时序知识图谱”:把对话拆成人、事、物和它们之间的关系,而且每条关系都记两个时间:事情什么时候为真,系统什么时候知道的。新事实和旧事实冲突时,旧的那条边会被标记失效,但历史保留。按它的论文,在一个长期记忆测试集上,这套做法比把全部历史塞进上下文的准确率更高(71.2% 对 60.2%),上下文从约 11.5 万 Token 降到 1600 个左右。YC 的 CEO Garry Tan 开源的 GBrain,也是用 Markdown 文件加上“在哪工作”“投资了谁”这类带类型的关系,自动连成一张网。
在这些形状之外,还有一类把记忆当“操作系统”来设计的思路:开源项目 Letta(前身是 MemGPT)把记忆分成三层,常驻上下文的“核心记忆”、可回翻的“对话记忆”、存在外部的“档案记忆”,模型自己决定什么时候把东西换进换出,就像操作系统管理内存和硬盘。另一个开源方案 Mem0,则是让模型从每段对话里抽出事实,再决定这条是新增、更新、删除还是忽略。
那本体论呢?
我研究生做的方向是本体论,所以看到“知识图谱”这几个字时,多想了一步。
本体和知识图谱不是一回事。 知识图谱是一张具体的网:张三在 A 公司工作,A 公司投资了 B。本体是这张网的“规则”:世界上有哪几类东西,“人”和“公司”之间能有哪几种关系,每种关系要满足什么约束。前者是数据,后者是对数据的定义。
今天大部分 AI 记忆系统,是没有显式本体的:存的是自由文字,什么都能往里写。GBrain 的“在哪工作”“投资了谁”、Zep 的实体类型,算是很轻的本体。Palantir 把本体做成了最贵的企业软件,但那是给企业数据用的,不是给个人记忆用的。
可是你仔细看,本体其实一直都在,只是换了个地方:
- 在产品规则里。 Claude 官方说明里“记什么”的五类、敏感信息的分级、永远不存的几类,本质上就是一套写入规则的本体:先定义有哪几类信息,再规定每一类能不能存、怎么存。
- 在审计时被“临时生成”出来。 我让 GPT 审计自己时,它没有吐出一堆零散句子,而是自动给出了一套结构:10 个维度,每条记忆都带上“性质、来源、证据强度、可能用途、风险”五个属性,还把“事实、偏好、历史行为、新推断”分开标。这就是一份用户画像的本体,只不过是在被追问时才长出来的。
所以我的判断是:大模型时代的本体,是一种“软本体”。 它不再像十几年前那样,由专家用 OWL 这类语言提前写死,而是由两部分组成:一小部分由产品硬性规定(什么不能存、哪些要分级、要标时间和来源),大部分由模型在整理记忆时自己归纳(宝可梦里的 global.md、Anthropic 研究里自动生成的维基)。
这也解释了为什么“做梦”这件事这么重要:归纳结构,是需要专门花时间去做的事。
五、为什么 AI 也要“做梦”
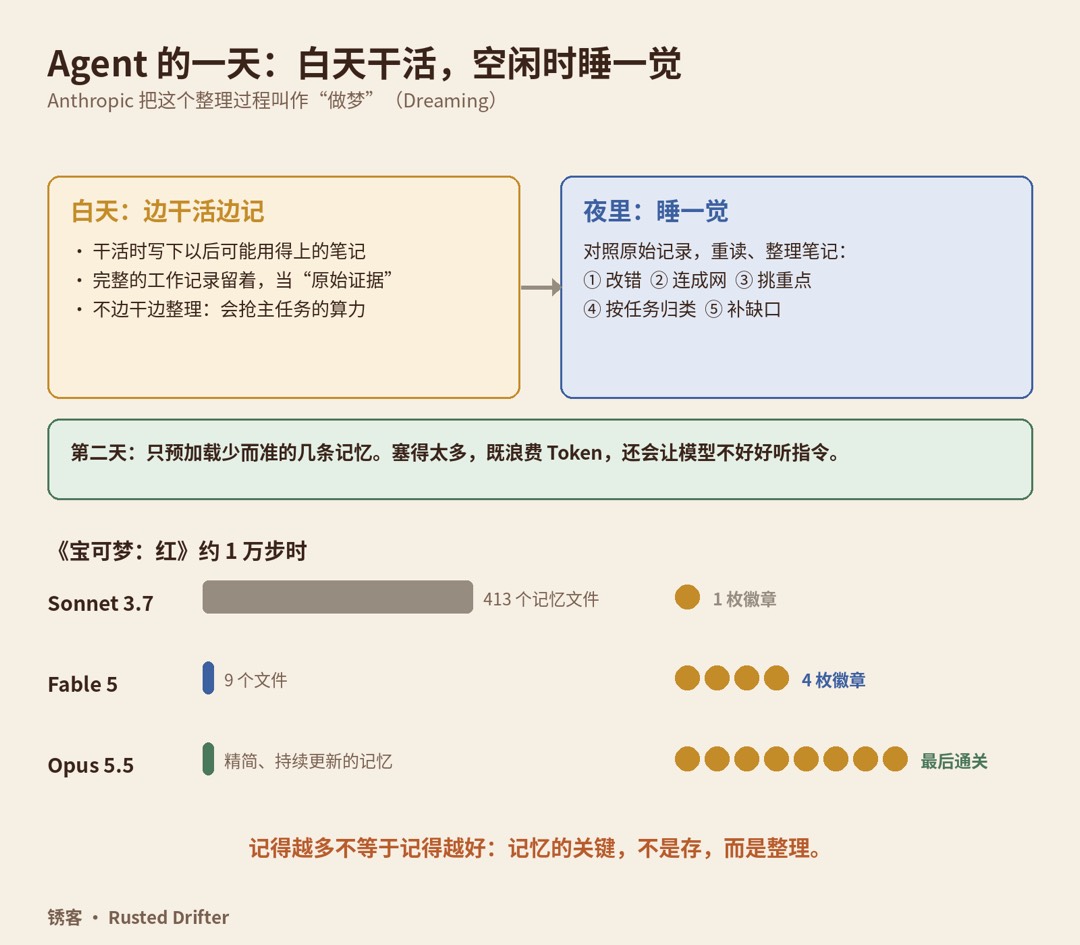
回到 Anthropic 那篇文章。它开头借用了人脑的分工:海马体在当下快速记录经历,只有一部分会在睡眠和安静休息时被“回放”,慢慢沉淀成长期知识。Agent 也可以这样分工:干活时先记下来,空闲时再整理。
为什么不能边干边整理?文章给了两个理由:一是边干边记会分散主任务的注意力;二是当下根本不知道什么重要。写下一条规则,其实是在预测“以后还会用到它”,而预测会错。
文章里有几组发现,我觉得对做产品的人最有用:
1. 会不会记,取决于模型会不会“验证”。 在一个持续学习的测试里,Sonnet 4.6 只会写下一堆没验证的猜想;Opus 4.7 开始区分“已核实”和“未核实”;到 Opus 5,每条记录都有规则、有依据、有踩坑警告,第一次形成了完整的学习闭环。
2. 只记“想明白的东西”,不记“随时看得到的东西”。 宝可梦里,Sonnet 3.7 把钱和坐标都记下来,可这些屏幕上随时看得到,记了反而一直过时。Fable 5 只记策略、计划和验证过的规则,比如连扔 7 个精灵球都没抓到一条鲤鱼王之后,它总结出“连续失败就调整按键节奏”。
3. 讲目的,不讲规则。 只告诉 Opus 4.7 和 Opus 5“有一个记忆文件夹可以用”,它们就明显提分;反过来规定“只记录失败”,记忆带来的提升反而丢了一大半。老一点的模型才需要手把手的提示。
4. 做梦能改错。 就是开头那个山洞的例子:没改的笔记,会在之后每一次会话里被读出来、被相信。
5. 做梦能把散笔记连成维基。 在一家公司约 35 万个文件、4.2 亿 Token 的文档上,做梦从 2 轮增加到 128 轮,只靠维基答题的得分从 13% 提高到 48%;维基加搜索一起用得 61%,只用搜索是 53%,每道题还省约 2 万 Token。在并购法律问题上,需要跨多份文件找答案的题,用维基得分 87%,只用搜索 73%。
但文章也写了反例:答案在单份文件里就能搜到时,维基没有帮助;有一次维基甚至比原始文件还大,像博尔赫斯小说里那张和帝国一样大的地图,什么都没抽象。
6. 顶层要小。 每次开工都自动加载的那一层,既占 Token,错一条还会带进每次会话,而且指令越长,模型越不容易遵守。所以做梦的很多工作,是把细节往下挪,只在顶层留索引。
7. 多个 Agent 写同一份记忆,会互相踩。 一个合同任务里,几个 Agent 同时往一张共享表里写,57 个关键事实只保住 41 个;改成一份合同一页、一个 Agent 负责、条款原文照录之后,57 个全部保住。
有意思的是,OpenAI 今年 6 月给 ChatGPT 的画像整理过程,也起名叫“做梦”;更早之前,Letta 和加州大学伯克利分校提出过“睡眠时间计算”,让模型利用两次交互之间的空闲时间整理上下文。各家不约而同地走到了同一个地方:记忆的关键,不在存,而在整理。
六、未来往哪走:几个判断
1. 从“全塞”到“分层”。 ChatGPT 赌的是上下文会越来越便宜,所以全塞;Anthropic 的研究说明,顶层越大,模型越不听话。我的判断是,主流做法会收敛到“小索引常驻 + 主题按需读取 + 原始记录可搜索”的三层结构,像 Claude Code 的 MEMORY.md 那样。
2. 从“记住你是谁”到“记住怎么做”。 今天大部分产品记的是事实和偏好;Agent 时代更值钱的,是经验:上次这件事是怎么做成的、在哪里踩过坑。越用越熟练,才是记忆真正的价值。
3. 结构会越来越强,本体会以“软”的方式回来。 从便签到画像到文件夹到图谱,结构在变强。但不会回到专家手写本体的老路,而是产品定规则、模型做归纳。
4. 记忆会变成新的“切换成本”。 上一篇写 ToC Agent 的商业困局时说过,今天的 AI 助手几乎没有切换成本。一个记住了你一年工作习惯的助手,换掉它的代价会越来越高。这也是 Claude 和 Gemini 都在做“记忆导入”的原因:先把别人的护城河,变成自己的入口。
5. 记忆治理会变成产品的核心能力。 96% 由系统自行写入、超过一半涉及心理推断,这样的记忆,用户需要知道它记了什么、凭什么记、能不能删。
我让 GPT 在审计报告最后给出了一套治理建议,分了五层,我觉得可以直接当作产品设计的参考:
- 可以长期保留的:语言、解释深度、结构偏好、长期的学科兴趣,用概括性的描述,定期确认是否变化;
- 有期限的:课程进度、求职方向、当前项目,要带时间戳和“计划 / 已完成”的状态,项目结束就不再默认使用;
- 只在需要时调用的:家人、未成年人、身份和医疗财务这类敏感信息,即时使用,不在无关问题里主动带出;
- 不应该当成事实的:对性格、情绪、执行力的推断,只能当作可撤销的低权重假设;
- 必须长期遵守的:用户明确说“这类事别记”,以后就不要主动提。
给产品经理的一句话:
记忆不是一个功能,是一套数据产品:记什么、谁来写、存成什么形状、什么时候拿出来、怎么整理、怎么忘、谁能看,每一项都是产品决策。
写在最后
十几年前读研究生,我做的方向是本体论:用一套概念和关系,去描述人的情绪。那时候觉得这是个很窄的学术题目,论文发出去,引用量也就几条。
这次审计 GPT 的时候,我盯着它给自己列的那张表看了很久:10 个维度,每条记忆带着来源、证据和风险,还有 8 条对我性格的推断。某种意义上,它在做的,正是当年我想做的事:用一套结构,去描述一个人。
不同的是,当年的本体是人一条一条写出来的;今天,是 AI 在“睡梦里”自己整理出来的。
至于它整理得对不对,可能需要我们自己,时不时去看一眼。
锈了,还在路上。
参考资料(核对日期 2026-11-10)
- Anthropic:The components of agent memory(2026-11-06,Lance Martin)
- Claude 帮助中心:Use Claude’s chat search and memory to build on previous context(2026-11)
- Shlok Khemani:ChatGPT Memory and the Bitter Lesson(2025-09);ChatGPT’s Memory Update Has a Packaging Problem(2026-06)
- Abhisek Dash 等:The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT(arXiv 2602.01450,2026-02)
- 硅星人 Pro:《ChatGPT 正在偷偷给你画像,用这段提示词让它交出来》(2026-11-02)
- GIGAZINE 等:ChatGPT 新一代记忆系统 Dreaming(2026-06)
- Rasmussen 等:Zep: A Temporal Knowledge Graph Architecture for Agent Memory(arXiv 2501.13956)
- Letta、UC Berkeley:Sleep-time compute(arXiv 2504.13171);MemGPT / Letta 记忆分层设计
- DataCamp:Gemini Personal Intelligence(2026-01)
- Mem0:How memory works in Claude Code(2026-09);Vectorize:GBrain 是什么(2026)